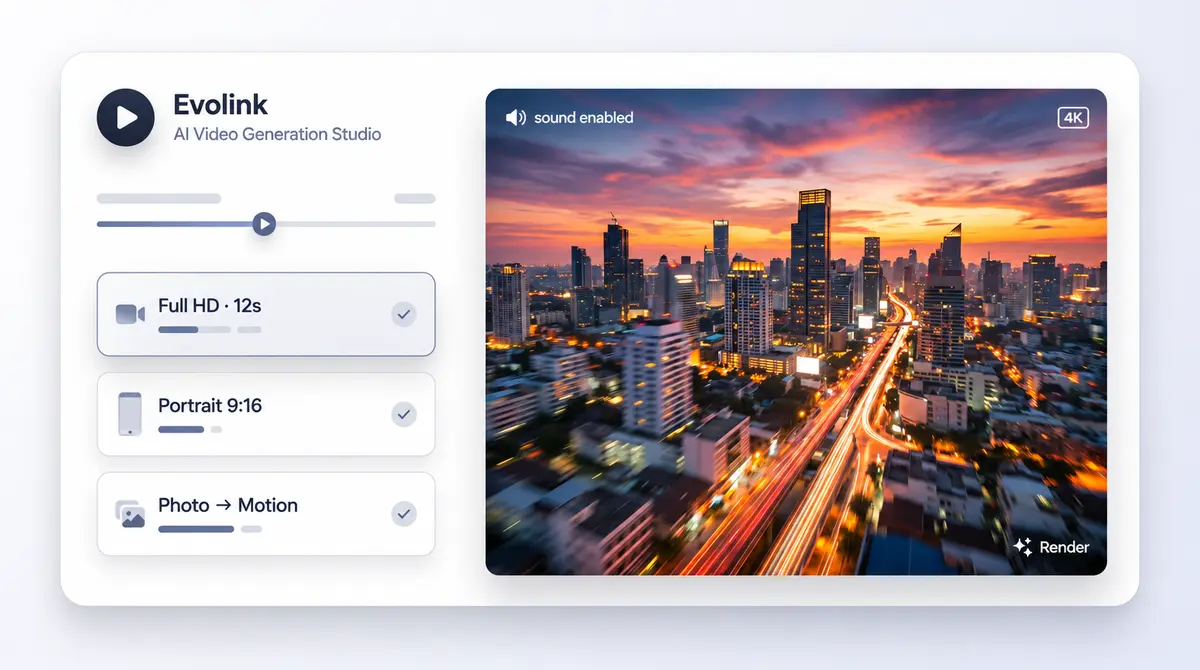
/ 01VIDEO
API de generación de video
Crea y edita clips desde 480p hasta 4K con audio nativo, control de fotogramas inicial y final, y referencias multimodales. Las opciones incluyen Seedance 2.5, Seedance 2.0, y MiniMax H3.
Ver modelos de vídeo →Evolink conecta tu código con los mejores modelos LLM, de imagen, vídeo y audio a través de un único endpoint. Compara especificaciones, consulta la documentación y lanza aplicaciones, agentes y pipelines.
Evolink no es ni un revendedor con descuento ni una galería de modelos. Es la capa que convierte añadir IA a un producto real en una decisión informada, no en una apuesta.
Consulta las capacidades, los límites y la documentación desde el principio. Cada endpoint de Evolink está documentado, así que nada se comporta de forma inesperada.
Ver el catálogo →Cambia entre GPT, Claude, Gemini o familias de medios según cambien las necesidades, sin reconstruir tu integración.
Compara las familias de modelos →Empieza por las especificaciones y las rutas de API, no por las demos. Cada punto de entrada de Evolink conduce a código que puedes desplegar.
Abrir la documentación →Los modelos de video, imagen, lenguaje y audio están todos detrás de Evolink. Compara las API líderes según los controles de los que depende tu flujo de trabajo.
Crea y edita clips desde 480p hasta 4K con audio nativo, control de fotogramas inicial y final, y referencias multimodales. Las opciones incluyen Seedance 2.5, Seedance 2.0, y MiniMax H3.
Ver modelos de vídeo →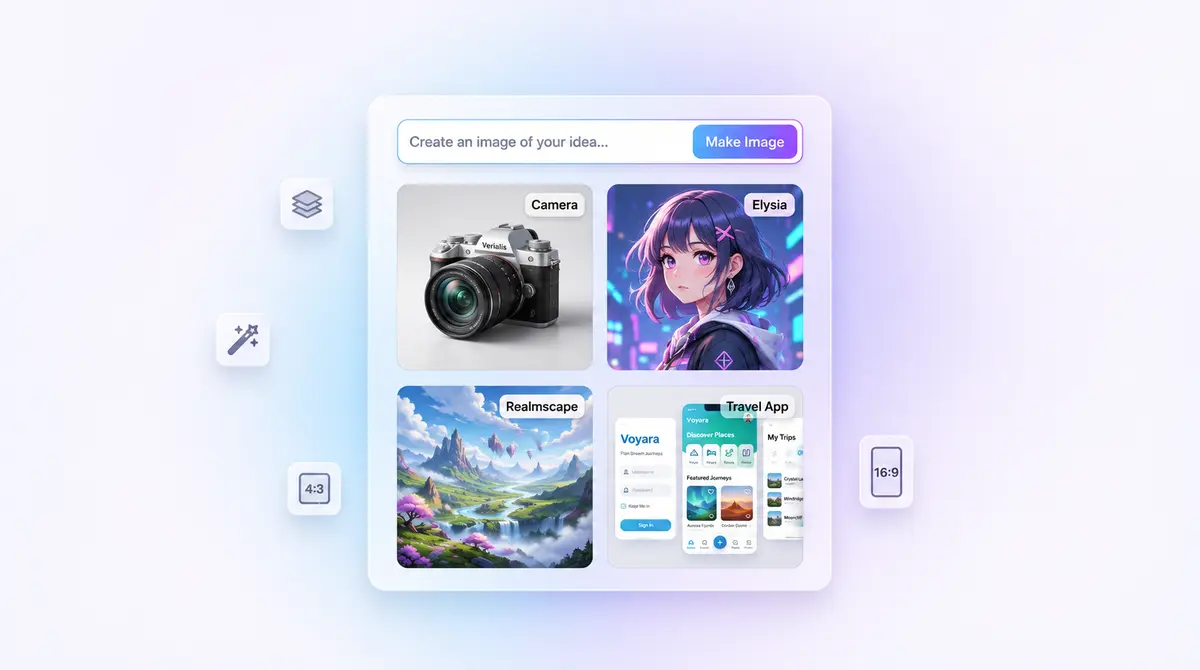
Genera a partir de texto o edita con instrucciones en lenguaje natural mientras mantienes la coherencia de personajes y productos. Prueba Seedream 5.0 Pro, Seedream 5.0 Flash, GPT Image 2, o Nano Banana 2.
Ver modelos de imagen →
Potencia el chat, el razonamiento, la programación y los agentes con llamadas a herramientas y salida estructurada. La línea incluye Claude Opus 5.5, Kimi K3, y GPT-6 Astra.
Ver modelos de lenguaje →
Genera canciones, voces, narración, diálogos con varias voces y efectos de sonido a partir de prompts. Usa Suno para pistas completas y Seed Audio 1.0 para un control preciso de la voz.
Ver modelos de audio →Alinea las versiones relacionadas por caso de uso y capacidad, luego elige la familia que se ajuste antes de integrarla en la API unificada de Evolink.
Revisa las versiones de GPT por razonamiento, programación, contexto y velocidad.
Revisa las versiones de Claude para agentes de programación y análisis de contexto largo.
Revisa las versiones de Gemini para entrada multimodal y respuestas rápidas.
Revisa las versiones de GPT Image para generación, edición y flujos creativos.
Infraestructura confiable, especificaciones de modelos claras y visibilidad del uso en tiempo real, para que tu equipo pueda lanzar con confianza.
99.9% de tiempo de actividad con conmutación por error automática.
Supervisa el uso y actualización de gasto en vivo.
Envía una solicitud y Evolink elige el mejor proveedor, enrutando al endpoint más rápido, más económico o más estable.
Especificaciones, límites y documentación para cada modelo, visible antes de tu primera llamada.
Una interfaz que habla los formatos SDK de OpenAI, Anthropic y Google, así que pasar a Evolink es un cambio de configuración, no una reescritura.
Regístrate en menos de un minuto y llega directamente a tu panel.
Emite una sola clave que funcione con todos los modelos compatibles.
Usa los estilos de solicitud de OpenAI, Anthropic o Google; la pasarela se adapta por sí sola.
Sustituye la URL base y la clave por las de Evolink, y el enrutamiento se activa de inmediato.
Lo que los equipos suelen preguntar antes de ejecutar Evolink en producción.
Evolink es una plataforma de API de modelos de IA que te ofrece 170+ modelos de 30+ proveedores, incluidos GPT, Claude, Gemini y Veo, a través de un único endpoint.
Las llamadas se miden por token, imagen o segundo de vídeo, y el panel de control desglosa el uso por modelo en tiempo real.
Normalmente minutos. Con un cliente estilo OpenAI, cambia la URL base y la clave; los SDK cubren Python, JavaScript y Go.
Los principales proveedores de LLM, imagen, video y audio, desde Claude y GPT hasta Seedance, Kling y Suno.
Evolink detecta la interrupción y redirige a un endpoint en buen estado, para que tu aplicación siga respondiendo.
La sobrecarga se mantiene por debajo de 50ms, y elegir al proveedor más rápido a menudo reduce el tiempo total de respuesta.
El tráfico se cifra en tránsito y el contenido de los prompts no se reutiliza para el entrenamiento de modelos.
No. Una sola clave de Evolink cubre todo el catálogo, con un único panel.
Obtienes conmutación por error, enrutamiento entre proveedores y una sola integración en lugar de varios SDK y cuentas.
Empieza, genera una clave y sigue la guía de inicio rápido para tu primera solicitud.
Un único endpoint. Todos los modelos. Diseñado para cargas de trabajo reales.